岁月无可回头(11)
工作半年,“我变强了,也变秃了”,不再是小年轻的模样,已是满脸胡须
年轻真好呀,可以
跑到海角之南,只为追一首歌的回忆
天不怕地不怕的闯
藐视一切
可惜,又不可惜
梦醒的感觉而已
美好又遗憾
2017年10月13日21:59:32 杭州
三年后,此时的我,回去翻这些文字(陆陆续续写了 11 篇),只能感叹 “没有岁月可回头” ~ 希望今后有更强大的内心,去面对更多挑战
2020年08月01日00:47:47 杭州
工作半年,“我变强了,也变秃了”,不再是小年轻的模样,已是满脸胡须
年轻真好呀,可以
跑到海角之南,只为追一首歌的回忆
天不怕地不怕的闯
藐视一切
可惜,又不可惜
梦醒的感觉而已
美好又遗憾
2017年10月13日21:59:32 杭州
三年后,此时的我,回去翻这些文字(陆陆续续写了 11 篇),只能感叹 “没有岁月可回头” ~ 希望今后有更强大的内心,去面对更多挑战
2020年08月01日00:47:47 杭州
etcd v3.1.9
to be cont.
boltdb 原哥们,不维护了貌似,coreos 的人继续维护 https://github.com/coreos/bbolt
另外这个 issues 和 free page 相关,即能解决部分 boltdb 内存碎片问题
https://github.com/coreos/bbolt/pull/3
bolt_unix.go 几个工具方法,如 flock / funlock / mmap / munmap
bolt_linux.go fsync db 文件
入口处在 db.go 的 Open 方法,通过 Open 方法初始化一个 db 文件;对应 etcd 中 mvcc/backend/backend.go 中的 newBackend 方法的调用
1 | func newBackend(path string, d time.Duration, limit int) *backend { |
Open 方法中,如果是新建的 db 文件,则调用 db.init() 写入 metadata 信息,boltdb 的注释写的很赞,感觉就是个工业又学术的艺术品,赞!
查看 db.init() 干了什么,直接上图吧,往 db 文件中写了四个 page (size 一般是 4096 字节) 的内容
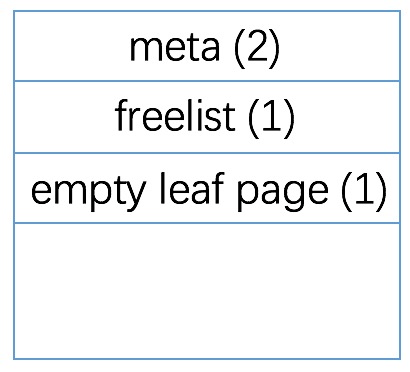
然后就是各种初始化了,初始化 pagePool,mmap the data file as a byte slice,初始化 freelist
etcd 的 InitialMmapSize 设置为 10 1024 1024 * 1024,吓人,那是否 etcd 一启动,就会占用这么大的实际内存?并不是的哈,在 mac 上实测 top 命令看到的是 314MB,ps aux 看到的 vsz 556879888,rss 476460,很好奇,按理来说 vsz 的单位应该是 kb 呀,但是这个数字有点儿大的吓人,实际应该是字节,也就是 500 多 MB,那么 rss 又怎么理解呢?rss 的单位又是 kb,实际使用了 470 多 MB?神奇,总之并不是启动之后立马占用 10 G内存
开头写两个一样的 meta page 貌似是为了做保护,看到 mmap 的方法中有这段注释
1 | // Validate the meta pages. We only return an error if both meta pages fail |
说直接一点儿,boltdb 使用 mmap 把一个名为 db 的文件映射到内存中的 []byte 数组,然后直接操作内存,但是不管怎么说是外部存储,最终还是要落盘的,所以呢推测是用了 B+ tree,然后把写入的内容组织成 page,使用指针操作,这块代码有点像 C 其实
freelist allocate 的逻辑是从 freelist 记录的所有 free page 中分配 n 个连续的 page
1 | // allocate returns the starting page id of a contiguous list of pages of a given size. |
freelist 的 write 实现
1 | // read initializes the freelist from a freelist page. |
freelist 的 read 实现,对应 write;如何 write 的,就如何 read
1 | // read initializes the freelist from a freelist page. |
freelist 的 reindex 实现,其实就是构造 cache,很直接的实现
1 | // reindex rebuilds the free cache based on available and pending free lists. |
boltdb 在 beginRWTx 中释放空间
1 | func (db *DB) beginRWTx() (*Tx, error) { |
查看 db.freelist.release 的实现
1 | // release moves all page ids for a transaction id (or older) to the freelist. |
leafPageElement 结构
1 | type leafPageElement struct { |
如图所示
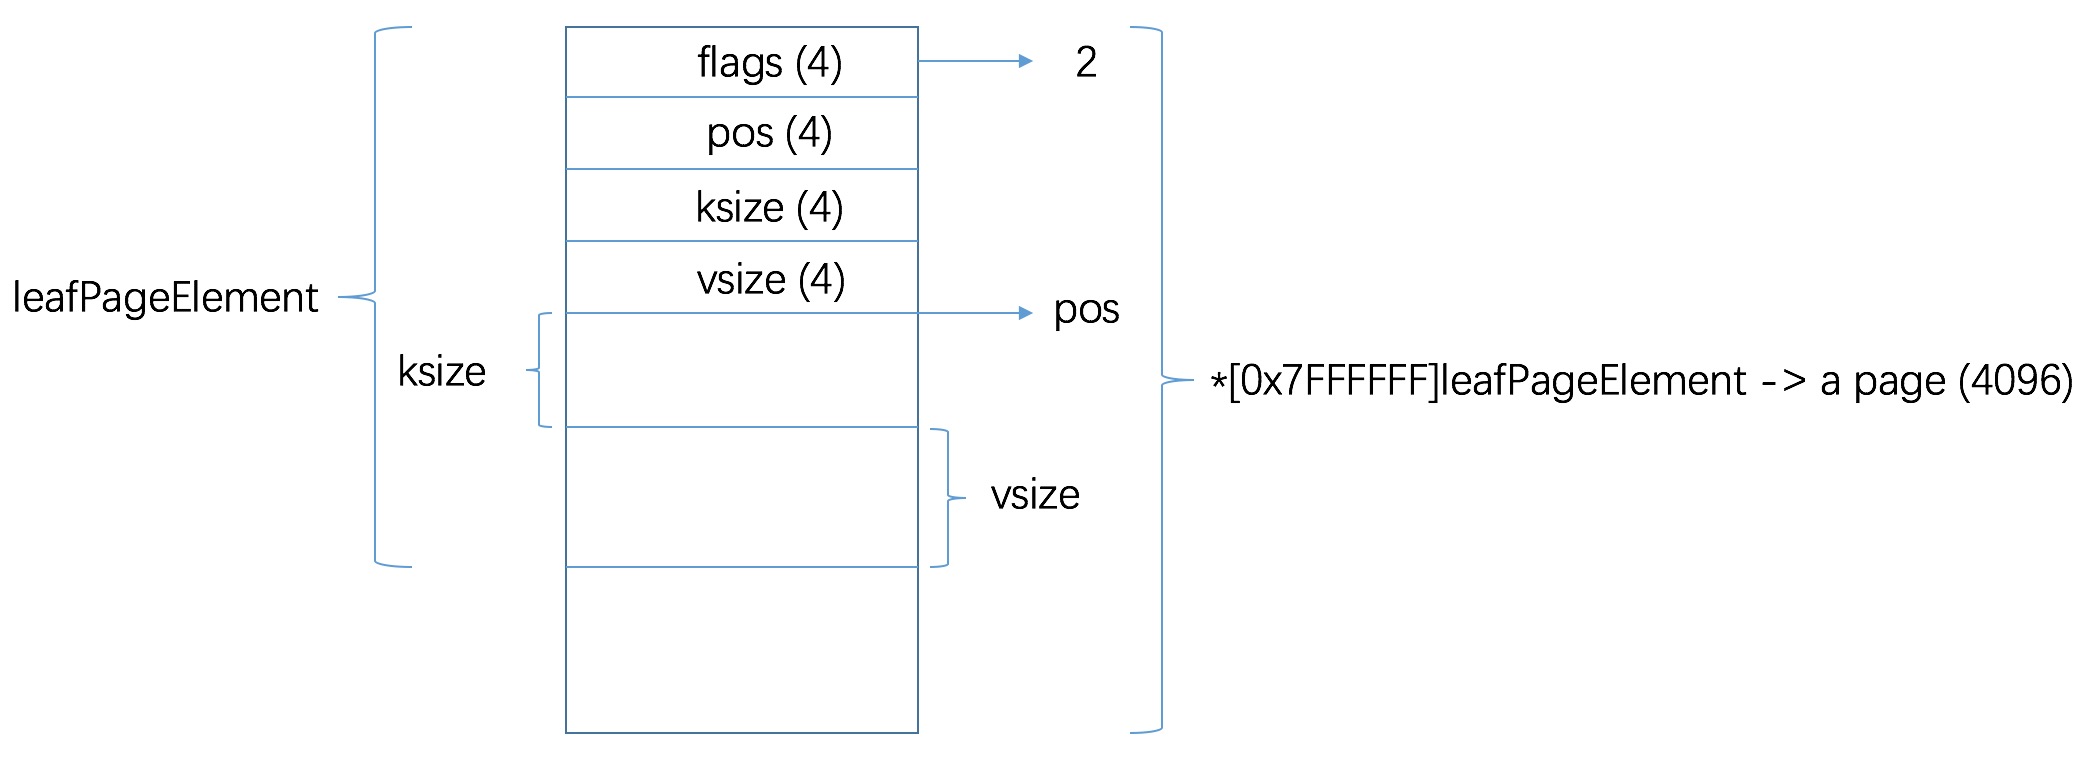
即叶子节点中存储了 key 和 value
查看 mvcc/kvstore.go 的 func (s *store) put(key, value []byte, leaseID lease.LeaseID) 方法
查看如下
1 | func (s *store) put(key, value []byte, leaseID lease.LeaseID) { |
查看 kvindex 的实现,实际上为 newTreeIndex(),即 mvcc/index.go,摘抄一句 package 注释
Package btree implements in-memory B-Trees of arbitrary degree.
okay, index 底层是 B tree
查看 kvindex.put 方法
1 | func (ti *treeIndex) Put(key []byte, rev revision) { |
kvindex 是个完全在内存中的索引,如果 etcd 重启了之后,需要恢复 kvindex 么?答案是需要的
etcdserver/server.go -> s.kv.Restore(newbe) -> func (s store) Restore(b backend.Backend) error {} -> func (s store) restore() error {}
在最后这个方法中从 db 文件恢复 kvindex
etcd v3.1.9
数据是如此重要,有必要看下 etcdctl restore 的实现
etcdctl 的实现均在 etcdctl 目录下,ctlv2 是 v2 的实现,ctlv3 是 v3 的实现,统一入口 main.go,通过环境变量 ETCDCTL_API 指定使用哪个版本的 etcdctl
查看 etcdctl/ctlv3/command/snapshot_command.go 中的 snapshotRestoreCommandFunc 方法
具体查看 makeDB 方法
1 | // makeDB copies the database snapshot to the snapshot directory |
具体查看 makeWALAndSnap 方法,无图言 x,makeWALAndSnap 生成的 .wal 和 .snap 文件内容如下
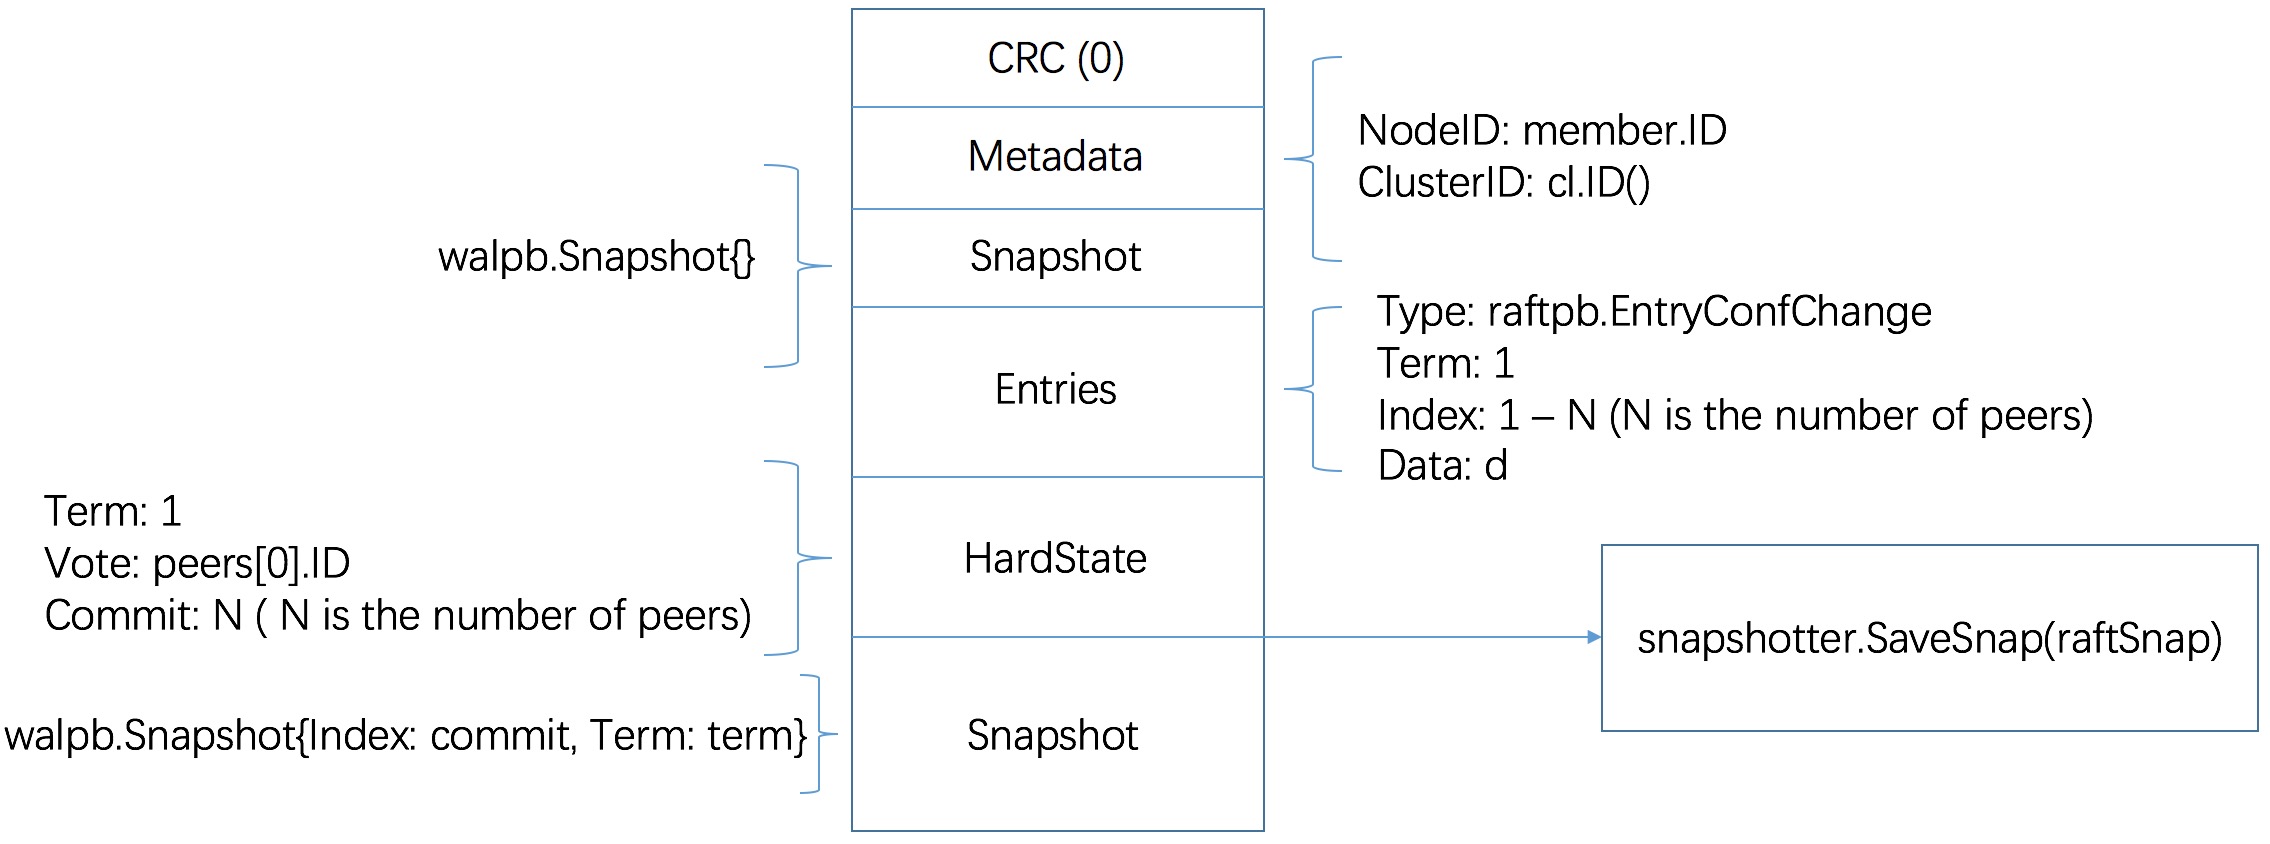
代码注释如下
1 | // makeWAL creates a WAL for the initial cluster |
etcd 完成一次写入需要经过哪些过程?
implementation of put grpc request
key.go
1 | func (s *kvServer) Put(ctx context.Context, r *pb.PutRequest) (*pb.PutResponse, error) |
v3_server.go
1 | func (s *EtcdServer) Put(ctx context.Context, r *pb.PutRequest) (*pb.PutResponse, error) |
v3_server.go
1 | func (s *EtcdServer) processInternalRaftRequest(ctx context.Context, r pb.InternalRaftRequest) (*applyResult, error) |
v3_server.go
1 | func (s *EtcdServer) processInternalRaftRequestOnce(ctx context.Context, r pb.InternalRaftRequest) (*applyResult, error) |
注册一个等待 id;完成之后调用 s.w.Trigger 触发完成 or GC
ch := s.w.Register(id)
raft propose (提议写入数据)
1 | // propose PutRequest |
node.go
1 | func (n *node) Propose(ctx context.Context, data []byte) error |
n.step 往 propc 通道传入数据
node run main roop
1 | func (n *node) run(r *raft) { |
raft/raft.go
1 | func (r *raft) Step(m pb.Message) error { |
r.step(r, m)
leader 和 follower 行为不同
对于 follower 来说
1 | func stepFollower(r *raft, m pb.Message) { |
r.send(m) 只是把 message append 到 raft/raft.go 的 msgs []pb.Message 数组中,谁去消费这个 message ?
node.go
1 | func newReady(r *raft, prevSoftSt *SoftState, prevHardSt pb.HardState) Ready { |
Ready 又是由谁消费的?
node.go main roop
func (n node) run(r raft)
1 | func (n *node) run(r *raft) { |
readyc 又由谁消费呢?
实际上 readyc 是 n.readyc,所以找下 n.readyc 由谁消费即可
1 | type node struct { |
所以我们继续追寻哪里取了 Ready() 通道
终于在
etcdserver/raft.go 中发现了
1 | func (r *raftNode) start(rh *raftReadyHandler) { |
该部分会将 apply 的 message 放入 applc 通道中,最终由
server.go
1 | func (s *EtcdServer) run() { |
做持久化,并且 trigger 写入结束
etcd v3.1.9
.wal 文件,即 write ahead log,wal 的实现集中在 wal 目录下
其中 wal/walpb 目录下定义了 wal 中记录的两种消息类型: Record 和 Snapshot
1 | message Record { |
用 pb 比较省事儿,不用自己实现对象序列化反序列化的逻辑
wal 有两个方法会创建 wal 文件,一个是 Create 方法,另一个是 cut 方法
Create 方法会创建初始 wal 文件,名称为 0000000000000000-0000000000000000.wal
1 | p := filepath.Join(tmpdirpath, walName(0, 0)) |
查看 Create 创建初始 wal 文件的过程
1 | // keep temporary wal directory so WAL initialization appears atomic |
w.renameWal(tmpdirpath) 值得抽出来说下
1 | // 删除原 wal path |
初始写入 wal 内容示意如下
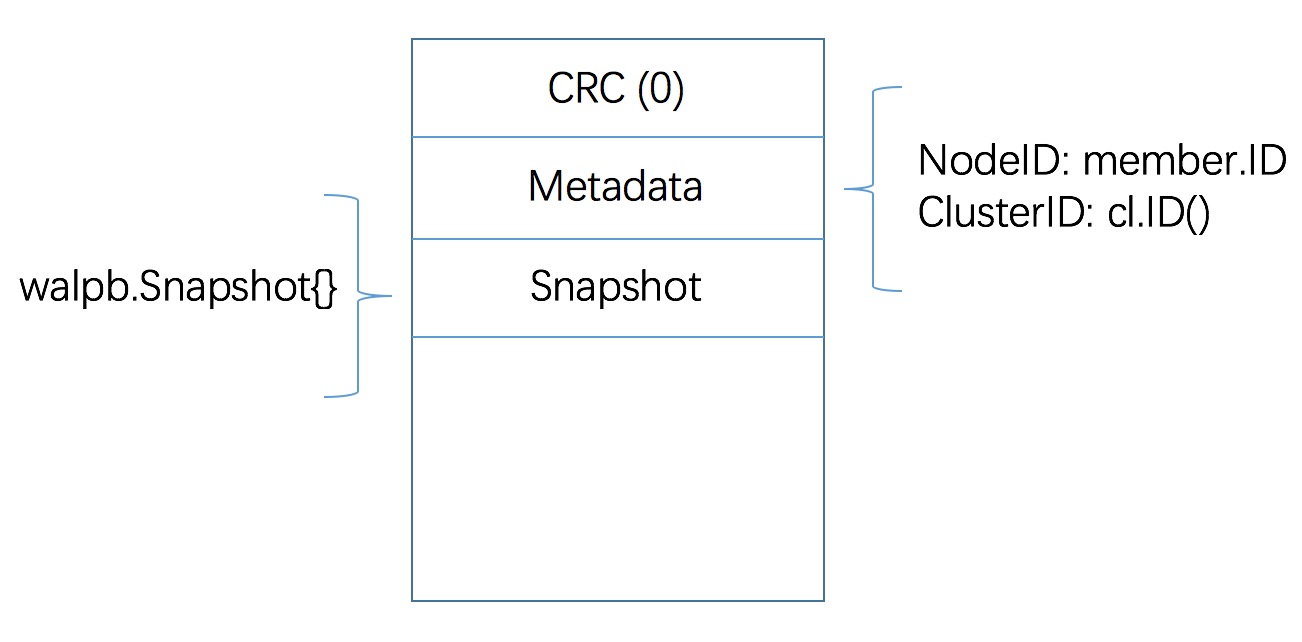
在 unix OS 上,首先会使用系统调用 Fallocate 预分配文件空间
如果 Fallocate 失败,则 fallback 到 preallocExtendTrunc 再次尝试分配
查看 preallocExtendTrunc 的逻辑
1 | // 移动到文件的当前读写位置,返回 offset |
在 darwin OS 上,首先会调用 preallocFixed,该函数中使用了系统调用 SYS_FCNTL 预先分配文件空间
如果 preallocFixed 失败,则调用 preallocExtendTrunc 再次尝试分配
wal/encoder.go 实现了写入逻辑
wal/decoder.go 实现了读取逻辑
wal/file_pipeline.go 用来预创建文件,为后续生成新的 wal 文件使用
fp.Open() 在 cut 方法中被调用,cut 中的调用如下
1 | // create a temp wal file with name sequence + 1, or truncate the existing one |
而 fp.Open() 从 fp.filec 中获取 locks file 返回
在初始化 file pipeline 方法 newFilePipeline 中启动 fp.run() 协程,查看 fp.run() 实现
1 | func (fp *filePipeline) run() { |
查看 fp.alloc() 方法
1 | func (fp *filePipeline) alloc() (f *fileutil.LockedFile, err error) { |
可见预生成了 [0-1].tmp 文件,并对该文件加了锁,待调用 fp.Open() 方法获取使用
wal 文件大小上限为 64MB
因此当写入消息之后, wal 文件大小 > 64MB 时,会调用 cut 方法
截断之前的 wal 文件,并生成新的 wal 文件用于写入
cut 的整体思路
详细阅读 cut 方法(保留了原注释)
1 | // cut closes current file written and creates a new one ready to append. |
所以 cut 方法初始写入 wal 的内容示意如下
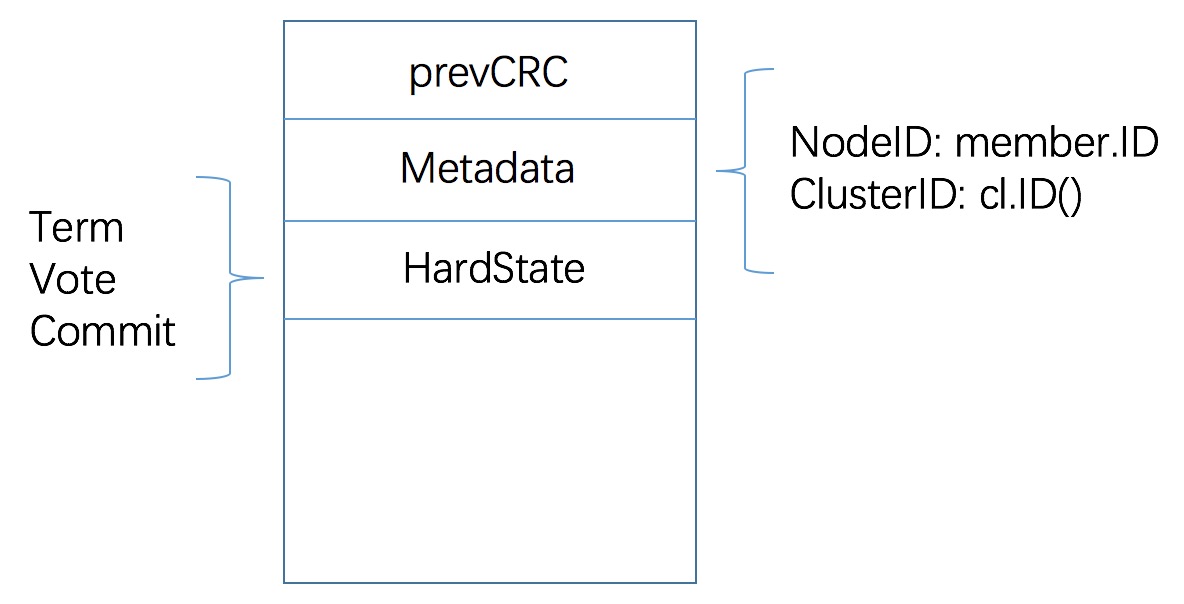
在 wal 中有如下几个地方使用了 sync 方法
sync 直接来说是使用了系统调用 fsync,确保数据写入磁盘持久化
1 | func (w *WAL) sync() error { |
重点看下 func (w *WAL) Save(st raftpb.HardState, ents []raftpb.Entry) error 方法,毕竟它调用频率较高
1 | func (w *WAL) Save(st raftpb.HardState, ents []raftpb.Entry) error { |
从上: vote / term 变化,或有 entries 要写入时,调用 w.sync
etcd v3.1.9
clientURL/health
1 | curl http://localhost:2379/health |
peerURL/members
1 | curl http://localhost:2380/members |
/raft
接收 raftpb.Message 消息,传递给 raft.Process 处理
检查 request id 是否已经被 remove
从 local 中获取 peer,如果不存在,则加入 remote 中 trace,并提示
1 | failed to find member [mid] in cluster [cid] |
检查 x-raft-to id 是否与本成员一致
(1) /raft/stream/msgapp
处理 streamTypeMsgAppV2 消息类型;建立 stream 链接,保持 w http.ResponseWriter
(2) /raft/stream/message
处理 streamTypeMessage 消息类型;建立 stream 链接,保持 w http.ResponseWriter
/raft/snapshot
/raft/probing
etcd v3.1.9
基于 protocol buffer,使用 gRPC 框架实现
示例代码:https://github.com/grpc/grpc-go/tree/master/examples
简单易用
pb 定义位于 etcdserver/etcdserverpb/rpc.proto 中,service 中定义了一系列 RPC 方法,RPC 中的 request 和 response 则在 service 之后被定义
使用 scripts/genproto.sh 可根据 pb 文件生成 go 文件
也可以根据官方文档使用 protoc 工具,从 pb 文件生成 go 文件
由 .proto 文件生成的 go 文件有两,如
1 | rpc.pb.go |
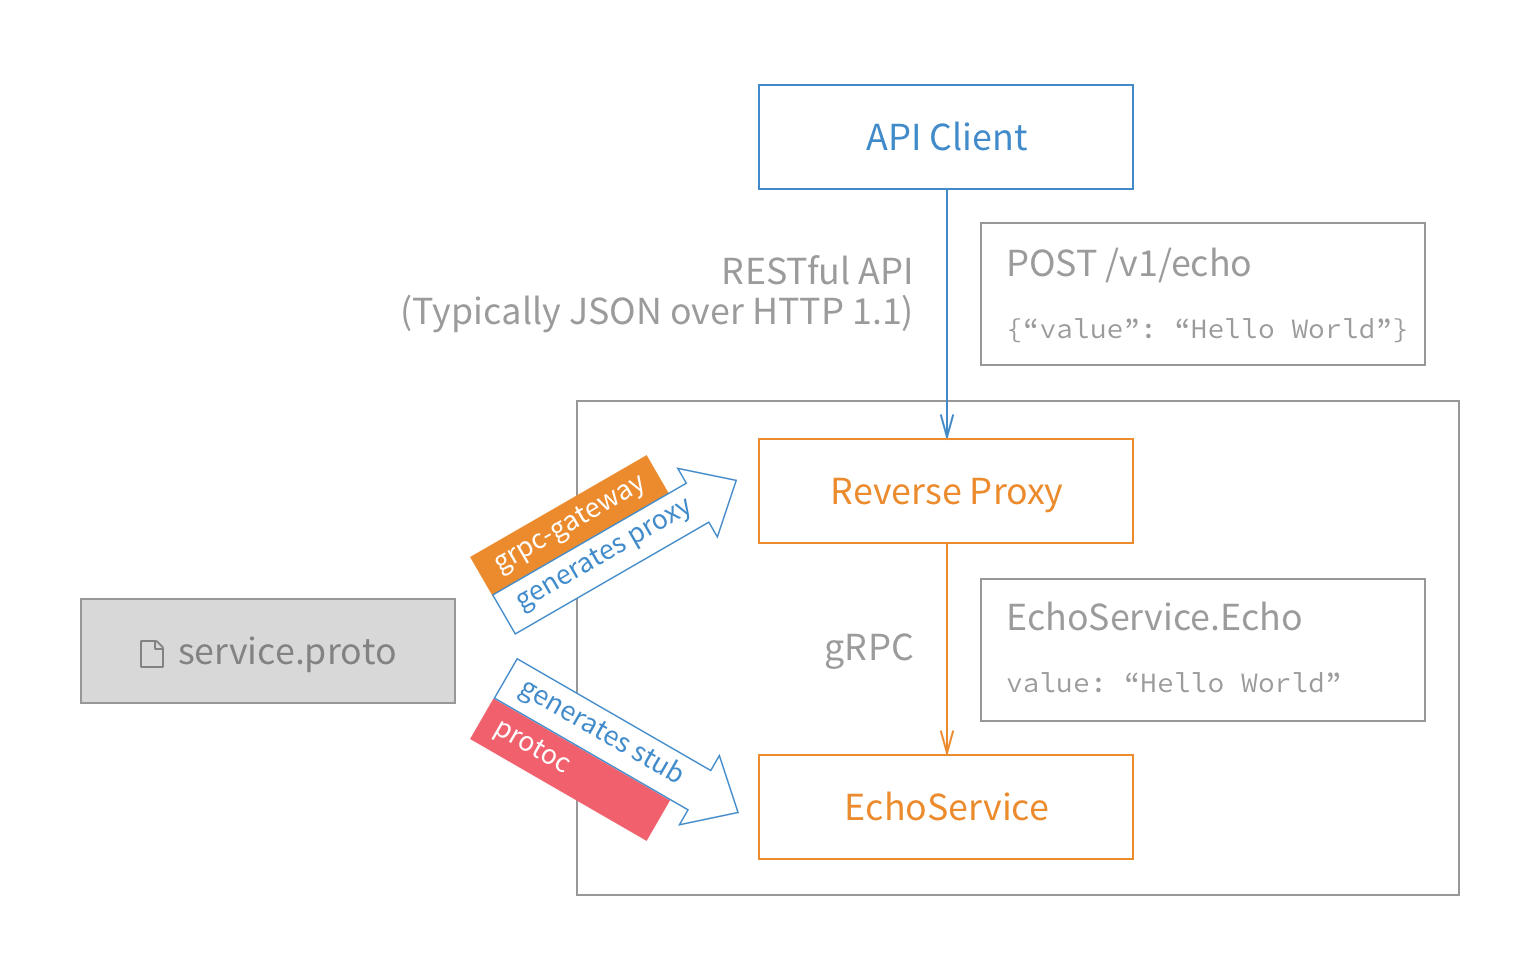
其中 rpc.pb.gw.go 是个反向代理,是将 http 请求再封成 grpc 发送至后端;按我理解就是方便使用 curl 命令调试
详情参考 ref: https://grpc.io/blog/coreos
下图源自上述网址,清晰明了;无图言 x
gRPC 的入口位于 etcdserver/api/v3rpc/grpc.go
该文件中 new 了 grpc server,注册了 pb 中定义的一系列 service,并返回 grpc server
v3 中保有 peer http,client http 及 client grpc
因此 v3 只是对 client 的 api 变为了 gRPC,peer 之间的通信仍然沿用 v2 的套路
简单的源码阅读
var stopped <-chan struct{}检查数据目录是否存在,若存在日志提示 (只有 data-dir 存在,就会打印如下日志)
1 | the server is already initialized as member before, starting as etcd member... |
不管数据目录存在与否,均如此启动
1 | stopped, err = startEtcd(cfg) |
最后获取到停止信号停止
1 | // etcd process stpo |
首先会从 initial-cluster 中初始化 peer 信息,利用这些 peer 信息新建 peer listener,主要方法为 rafthttp.NewListener
接下来使用 listen-client-url 新建 client listener,这块直接使用 net.Listen 方法,开启 tcp 服务;然后判断系统文件描述符限制,如果 < 150,则 panic,然后限制 listener 的数量为 系统描述符限制 - 150
初始化 net.Listen 的 keepAliveListener
初始化 etcd server config
初始化 etcdserver
启动 etcdserver
注册操作系统终止回调函数 osutil.RegisterInterruptHandler(s.Stop)
使用 cors 初始化 clientHandler
使用 etcdhttp 初始化 peerHandler
goroutine 为每个 peer listener 开启 http 服务 处理请求,5 min read timeout
goroutine 为每个 client listener 开启 http 服务 处理请求,0 min read timeout // 与 golang 的一个 bug 有关
etcdhttp/peer.go
etcdhttp/client.go
其实是 http server,待阅读
最后,返回停止通道及错误
初始化 etcdserver
集群信息存在 /0
key 信息存在 /1
检查数据目录版本,并更新数据目录
判断以何种方式启动
(1) !haveWAL && !cfg.NewCluster
没有 wal 目录且 new-cluster == false,此时通过从启动参数 initial-token 及 initial-cluster 配置的集群信息来访问集群(会将自己的 peer url 排除),获取到当前存在的集群信息
校验 启动参数中配置的集群信息与获取到存在的集群信息,并为 local member 设置 id
此时成员信息从 remote peer 中获取,当前 server 的 cluster id 被设置为 remote peer 中获取到 cluster id
打印启动参数 cfg.Print()
启动 raftnode
1 | id, n, s, w = startNode(cfg, cl, nil) |
简单的源码阅读
admin guide debug part,可以打开 debug 级别日志,亦可单独打开特定 package 的 debug 日志)var stopped <-chan struct{}检查数据目录是否存在,若存在日志提示 (只有 data-dir 存在,就会打印如下日志)
1 | the server is already initialized as member before, starting as etcd member... |
不管数据目录存在与否,均如此启动
1 | stopped, err = startEtcd(cfg) |
最后获取到停止信号停止
1 | // etcd process stpo |
首先会从 initial-cluster 中初始化 peer 信息,利用这些 peer 信息新建 peer listener,主要方法为 rafthttp.NewListener
接下来使用 listen-client-url 新建 client listener,这块直接使用 net.Listen 方法,开启 tcp 服务;然后判断系统文件描述符限制,如果 < 150,则 panic,然后限制 listener 的数量为 系统描述符限制 - 150
初始化 net.Listen 的 keepAliveListener
初始化 etcd server config
初始化 etcdserver
启动 etcdserver
注册操作系统终止回调函数 osutil.RegisterInterruptHandler(s.Stop)
使用 cors 初始化 clientHandler
使用 etcdhttp 初始化 peerHandler
goroutine 为每个 peer listener 开启 http 服务 处理请求,5 min read timeout
goroutine 为每个 client listener 开启 http 服务 处理请求,0 min read timeout // 与 golang 的一个 bug 有关
etcdhttp/peer.go
etcdhttp/client.go
其实是 http server,待阅读
初始化 etcdserver
集群信息存在 /0
key 信息存在 /1
检查数据目录版本,并更新数据目录
判断以何种方式启动
(1) !haveWAL && !cfg.NewCluster
没有 wal 目录且 new-cluster == false,此时通过从启动参数 initial-token 及 initial-cluster 配置的集群信息来访问集群(会将自己的 peer url 排除),获取到当前存在的集群信息
校验 启动参数中配置的集群信息与获取到存在的集群信息,并为 local member 设置 id
此时成员信息从 remote peer 中获取,当前 server 的 cluster id 被设置为 remote peer 中获取到 cluster id
打印启动参数
1 | cfg.Print() |
启动 raftnode
1 | id, n, s, w = startNode(cfg, cl, nil) |
(2) !haveWAL && cfg.NewCluster
没有 wal 目录且 NewCluster == true
判断 isMemberBootstrapped,从 remote peer 中获取集群信息,如果 server id 已经存在集群中且其 client url 不为空,则表示已经被启动过了,返回错误
1 | member XXX has already been bootstrapped |
打印启动参数,并启动 raftnode
1 | cfg.PrintWithInitial() |
可见
参数是用来 bootstrap 成员用的
(3) haveWAL
有 WAL 目录的情况
data-dir/member
data-dir/member/wal
data-dir/member/snap
load snapshot 文件
从 snapshot 文件中恢复
最后启动 raftNode
1 | cfg.Print() |
注意备份文件恢复时,一定要使用 force-new-start 的原理就在这里了
判断完了以何种方式启动 raftnode 之后,开始初始化 EtcdServer,并且初始化 rafthttp.Transport,启动 rafthttp.Transport,将从 remote peer 获取到的 peer url 信息全部加入 tr.AddRemote,AddRemote 中会判断是否已经存在 peer 或者 remote 中,已存在则不再加入;将 cluster 中的 member 信息全部加入 tr.AddPeer
当然都是除了自己,加入之前判断了 id,如果 id == 本身则不加入
不过我还是不太明白 remote 和 peer 有啥区别,目前
得看看 remote.go 和 peer.go 都干了什么
注册 server 信息到 cluster 中,并更新 server 的静态 client url
publish 的过程比较直接,调用 pb.Request 方法,将其 attributes 即 name 和 clientURLs 写入集群中
即写入 key / value 中 (v2 的存储)
key 的格式为 /0/members/id/attributes
实践中,当成员无法 publish 至集群时,一般发生的错误为超时;超时后会重试,毕竟是个 for loop,在 publish 成功或者成员停止时直接 return 结束 for loop 否则会持续 publish
启了个 goroutine 删除超出 threshold 的 snap 和 wal 文件
启了个 goroutine 检查系统当前使用的 fd 数量是否超过了 limit 的 80%
启了个 goroutine 检查集群 version
设置默认 snapshotCount,初始化 done / stop 通道,打印集群版本信息,goroutine run
raftnode start
待阅读
newPeerStatus(to)
这个结构体中提供了 activate / deactivate 方法
即日志中常见的 the connection with [Member ID] became active 信息
随后初始化了 remote 结构体
remote 结构体中初始化了 pipeline
sync.waitGroup 初始化为 4
启了 4 个 goroutine 跑 handle
handle 从 msgc 通道中获取 raftpb.Message,并使用 post 方法发送出去
waitGroup 在 stop 方法内调用 wait,确保 handle goroutine 均已关闭
newPeerStatus(to)
初始化 peer 结构体
初始化 msgAppV2Writer: msgAppV2Writer / writer: startStreamWriter
初始化 pipeline: newPipeline / snapSender: newSnapshotSender
goroutine startPeer 从 recvc 通道中获取 message 交由底层 raft 处理
goroutine startPeer 从 propc 通道中获取 message 交由底层 raft 处理
初始化 p.msgAppV2Reader = startStreamReader
初始化 p.msgAppReader = startStreamReader
1 | // peer is the representative of a remote raft node. Local raft node sends |
peer 是 remote raft node 的代表,本地 raft node 通过 peer 发送 message 到 remote
stream and pipeline
pipeline 是一系列 http clients,用于向 remote 发送 http 请求,它只有在 stream 没有建立起来时使用
stream 是接收者 long-polling 链接,用于传递 message;另外 raft leader 使用优化过的 stream 发送 msgApp 信息
stream run 起来之后,尝试去 dial 远端,dial 未返回错误后,将 peerStatus 设置为 active,即此时日志中会打印 the connection with [Member ID] became active
dial 如果返回 errUnsupportedStreamType 亦或是 err := cr.decodeLoop(rc, t) 返回的 err 不是 EOF 或者链接被关闭,则 peerStatus 被设置为 inactive
stream 每 100 ms 会重新尝试 dial remote peer,如果出现 request sent was ignored (cluster ID mismatch: remote[remote member id]=X-Etcd-Cluster-ID in http header, local=local cluster id) 错误的话,那么这个错误日志的打印频率将会很高,需要及时处理
stream 将获取到的 raftpb.Message 放入相应的通道 recvc / propc
相比 k8s 的复杂来说,etcd 的代码阅读算是还能摸得着头的了
etcd v3.1.9
1 | cl, err = membership.NewClusterFromURLsMap(cfg.InitialClusterToken, cfg.InitialPeerURLsMap) |
上述方法从 –initial-cluster-token and –initial-cluster 这个两个启动参数中生成 Cluster ID 和各个 Member ID
NewClusterFromURLsMap 这个方法中调用 NewMember 生成 Member ID
首先来看 NewMember 方法
1 | func NewMember(name string, peerURLs types.URLs, clusterName string, now *time.Time) *Member |
核心思路
1 | b []byte: peerUrls + clusterName + time |
Member ID 根据 peerUrls / clusterName / current_time 的 sha1 sum 值,取其前 8 个 bytes,为 16 位的 hex 数
回到 NewClusterFromURLsMap 方法中的 NewMember(代码如下)可见最后一个参数为 nil,即不加入时间因素,因此 NewClusterFromURLsMap 生成的 Member ID 是固定的
1 | m := NewMember(name, urls, token, nil) |
直接从 server 端看起 —— etcdserver/api/v3rpc/member.go 中的 MemberAdd 方法
可见如下代码
1 | urls, err := types.NewURLs(r.PeerURLs) |
m := membership.NewMember(“”, urls, “”, &now) 加入了当前时间,因此 Member ID 是不确定的
cluster ID 仅生成一次,此后不会变化
通过 etcd 启动参数生成 (initial-cluster) 的 Member ID 固定
通过 Member add 生成的 Member ID 不确定
Member add 的时候,没有传递 member 的 name,因此 member add 成功时,member list 出来的 member item,新加入的 member 其 name 为空,且没有 client url,因该 member 尚未 publish 其 client url 到集群中